
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT) es un método genérico diseñado para el ajuste fino de modelos de base. Mejora la eficiencia de parámetros del paradigma de ajuste fino — Orthogonal Finetuning (OFT), tomando inspiración de la transformada rápida de Fourier de Cooley-Tukey, mostrando resultados favorables al ajustar diferentes modelos de base, incluidos grandes transformadores de visión, grandes modelos de lenguaje y modelos de difusión de texto a imagen.
El resumen del artículo es:
Los grandes modelos de base se están volviendo ubicuos, pero entrenarlos desde cero es prohibitivamente costoso. Por lo tanto, adaptar de manera eficiente estos modelos potentes a tareas de bajo nivel es cada vez más importante. En este artículo, estudiamos un paradigma de ajuste fino fundamentado: el ajuste fino ortogonal (Orthogonal Finetuning, OFT) para la adaptación a tareas de bajo nivel. A pesar de demostrar una buena capacidad de generalización, OFT sigue utilizando un número bastante grande de parámetros entrenables debido a la alta dimensionalidad de las matrices ortogonales. Para abordar esto, comenzamos examinando OFT desde la perspectiva de la transmisión de información y luego identificamos algunos requisitos clave que permiten una mayor eficiencia en el uso de parámetros. Inspirados en cómo el algoritmo de transformada rápida de Fourier de Cooley-Tukey permite una transmisión de información eficiente, proponemos una parametrización ortogonal eficiente que utiliza estructuras de mariposa. Aplicamos esta parametrización a OFT, creando un nuevo método de ajuste fino eficiente en parámetros, llamado Orthogonal Butterfly (BOFT). Al subsumir OFT como un caso especial, BOFT introduce un marco generalizado de ajuste fino ortogonal. Finalmente, realizamos un estudio empírico extenso sobre la adaptación de grandes transformadores de visión, grandes modelos de lenguaje y modelos de difusión de texto a imagen a diversas tareas de bajo nivel en visión y lenguaje.
BOFT se centra en preservar las capacidades generativas de un modelo preentrenado, siendo significativamente más eficiente en parámetros que el OFT estándar. Al igual que OFT, BOFT mantiene la misma similitud coseno (energía hipersférica) entre todas las neuronas de un mismo nivel al aplicar una transformación ortogonal a la matriz de pesos preentrenada, lo que garantiza que se conserven las relaciones semánticas entre las neuronas.
En lugar de utilizar una matriz ortogonal bloque-diagonal, BOFT factoriza la transformación ortogonal en un producto de matrices de mariposa dispersas (introducidas originalmente en la FFT de Cooley–Tukey). A diferencia de las rotaciones bloque-diagonales de OFT, que solo mezclan las entradas dentro de cada bloque, la estructura de mariposa garantiza que cada entrada pueda influir en cada salida, produciendo una conectividad densa con solo O(d log d) parámetros. Esta factorización preserva la expresividad mientras reduce drásticamente la cantidad de parámetros en comparación con OFT (a costa del tiempo de cómputo).
En la práctica, BOFT multiplica cada matriz de pesos preentrenada por una secuencia de factores ortogonales con estructura de mariposa, lo que permite rotaciones de neuronas eficientes y expresivas. Esto hace que BOFT sea adecuado para la generación controlable y para tareas donde es crítico mantener la representación del sujeto del modelo preentrenado, al tiempo que escala a modelos más grandes con menor sobrecarga de memoria y cómputo.
BOFT se puede aplicar a cualquier subconjunto de matrices de pesos en una red neuronal para reducir el número de parámetros entrenables. Dadas las capas objetivo para la inyección de parámetros de BOFT, el número de parámetros entrenables se puede determinar en función del tamaño de las matrices de pesos.
Resumen de las pruebas de rendimiento
Fusionar los pesos de BOFT en el modelo base
De manera similar a LoRA, los pesos aprendidos por BOFT pueden integrarse en las matrices de pesos preentrenadas mediante la función [~BOFTModel.merge_and_unload(). Esta función fusiona los pesos del adaptador con el modelo base, lo que permite utilizar el modelo recién fusionado de forma efectiva como un modelo independiente.
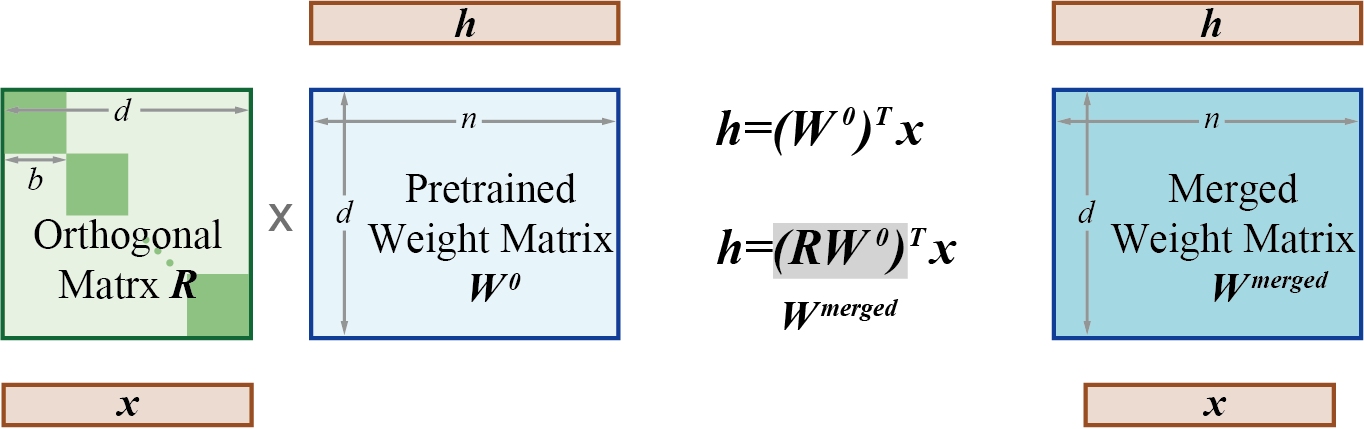
Esto funciona porque, durante el entrenamiento, la matriz de pesos ortogonal (R en el diagrama anterior) y las matrices de pesos preentrenadas son independientes. Pero una vez que el entrenamiento está completo, estos pesos pueden fusionarse (multiplicarse) en una nueva matriz de pesos equivalente.
Uso de ejemplo de BOFT
Para un ejemplo de la aplicación del método BOFT a diversas tareas de bajo nivel, consulte las siguientes guías:
Echa un vistazo a las siguientes guías paso a paso sobre cómo ajustar un modelo con BOFT:
Para la tarea de clasificación de imágenes, se puede inicializar la configuración BOFT para un modelo DinoV2 de la siguiente manera:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
clase peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
Parámetros
- boft_block_size (
int) — Tamaño de bloque de la matriz BOFT a través de las diferentes capas, expresado enint. Los tamaños de bloque más grandes resultan en matrices de actualización más densas con más parámetros entrenables. Elijaboft_block_sizepara que sea divisible por la dimensión de entrada de la mayoría de las capas (in_features), por ejemplo, 4, 8, 16. Además, especifique soloboft_block_sizeoboft_block_num, pero no ambos simultáneamente ni deje ambos en 0, porqueboft_block_sizexboft_block_numdebe ser igual a la dimensión de entrada de la capa. - boft_block_num (
int) — Número de bloques BOFT por capa inyectada. Unboft_block_nummayor resulta en matrices de actualización más dispersas con menos parámetros entrenables. Nota, elijaboft_block_numpara que sea divisible por la dimensión de entrada de la mayoría de las capas (in_features), por ejemplo, 4, 8, 16. Especifique soloboft_block_sizeoboft_block_num, pero no ambos simultáneamente ni deje ambos en 0, porqueboft_block_sizexboft_block_numdebe ser igual a la dimensión de entrada de la capa. - boft_n_butterfly_factor (
int) — Número de factores de mariposa entre las distintas capas. Paraboft_n_butterfly_factor=1, BOFT es igual al OFT estándar; paraboft_n_butterfly_factor=2, el tamaño efectivo de bloque de OFT se duplica y el número de bloques se reduce a la mitad. - target_modules (
Union[List[str],str]) — Los nombres de los módulos a los que se aplicará el adaptador. - exclude_modules (
Optional[Union[List[str], str]]) — Los nombres de los módulos a los que no se aplicará el adaptador. Al pasar una cadena de caracteres, se realizará una coincidencia mediante expresión regular. Al pasar una lista de cadenas de caracteres, se realizará una coincidencia exacta o se comprobará si el nombre del módulo termina con alguna de las cadenas de caracteres pasadas. - boft_dropout (
float) — La probabilidad de dropout multiplicativo, que se logra estableciendo los bloques OFT como identidad durante el entrenamiento, de manera similar a la capa de dropout en LoRA. - fan_in_fan_out (
bool) — Establezca este valor en True si la capa que se va a reemplazar almacena los pesos como (fan_in, fan_out). Por ejemplo, gpt-2 utilizaConv1D, que almacena los pesos como (fan_in, fan_out), por lo que este valor debe establecerse enTrue. - bias (
str) — Tipo de sesgo para BOFT. Puede ser ‘none’, ‘all’ o ‘boft_only’. Si se establece en ‘all’ o ‘boft_only’, los sesgos correspondientes se actualizarán durante el entrenamiento. Tenga en cuenta que esto significa que, incluso al desactivar los adaptadores, el modelo no producirá la misma salida que habría generado el modelo base sin adaptación. - modules_to_save (
List[str]) —Lista de módulos, aparte de las capas BOFT, que se configurarán como entrenables y se guardarán en el punto de control final. - layers_to_transform (
Union[List[int],int]) — Los índices de las capas a transformar. Si se especifica este argumento, se aplicarán las transformaciones BOFT a los índices de capa indicados en esta lista. Si se pasa un solo entero, se aplicarán las transformaciones BOFT a la capa en ese índice. - layers_pattern (
Optional[Union[List[str], str]]) — El nombre del patrón de capas, utilizado solo silayers_to_transformes diferente deNoney si el patrón de capas no está en el patrón de capas común. Esto debe apuntar alnn.ModuleListdel modelo, que a menudo se llama'layers'o'h'.
Esta es la clase de configuración para almacenar la configuración de un BOFTModel.
BOFTModel
clase peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Parámetros
- model (transformers.PreTrainedModel) — El modelo que se va a adaptar.
- config (BOFTConfig) — La configuración del modelo BOFT.
- adapter_name (
str) — El nombre del adaptador, por defecto es"default". - low_cpu_mem_usage (
bool,optional, defaults toFalse) — Crea pesos de adaptador vacíos en el dispositivo meta. Útil para acelerar el proceso de carga.
Devuelve
torch.nn.Module
El modelo BOFT.
Crea un modelo BOFT y OFT a partir de un modelo de transformers preentrenado. Artículo: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
Ejemplo:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)Atributos:
- model (transformers.PreTrainedModel) — El modelo que se va a adaptar.
- peft_config (BOFTConfig): La configuración del modelo BOFT.